
End of training
Browse files- .gitattributes +1 -0
- README.md +33 -52
- all_results.json +16 -17
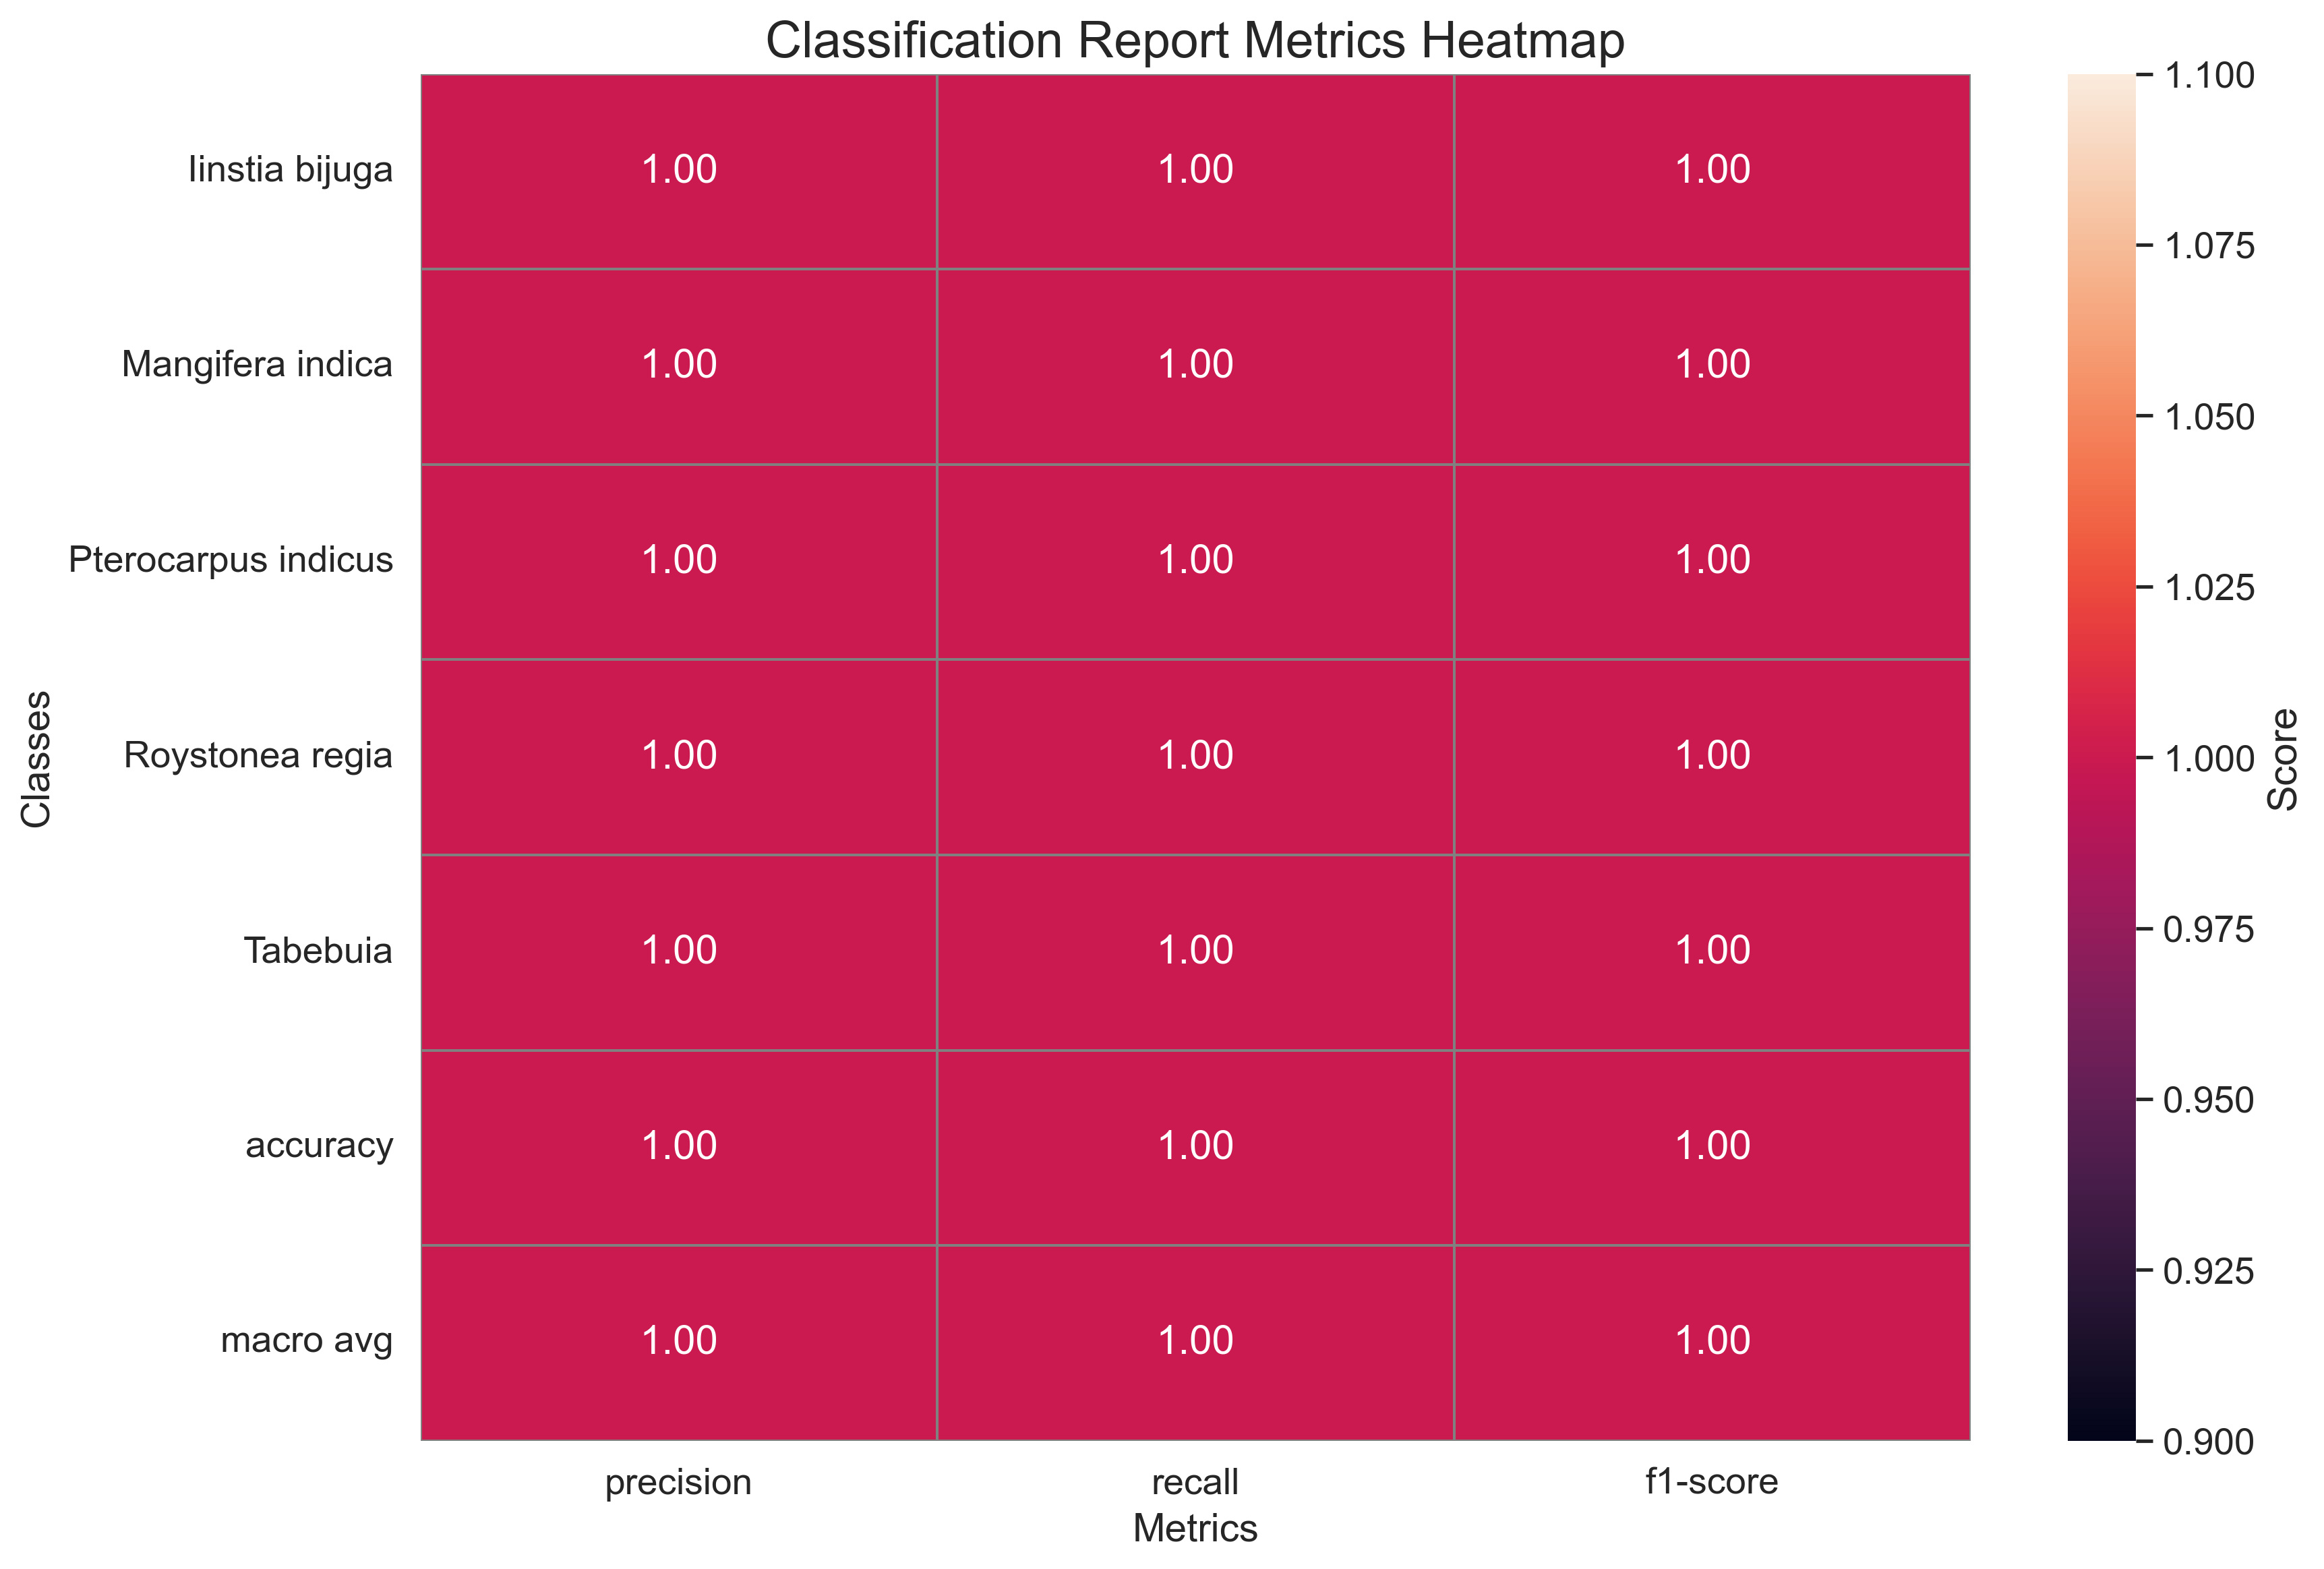
- classification_report.png +0 -0
- config.json +1 -1
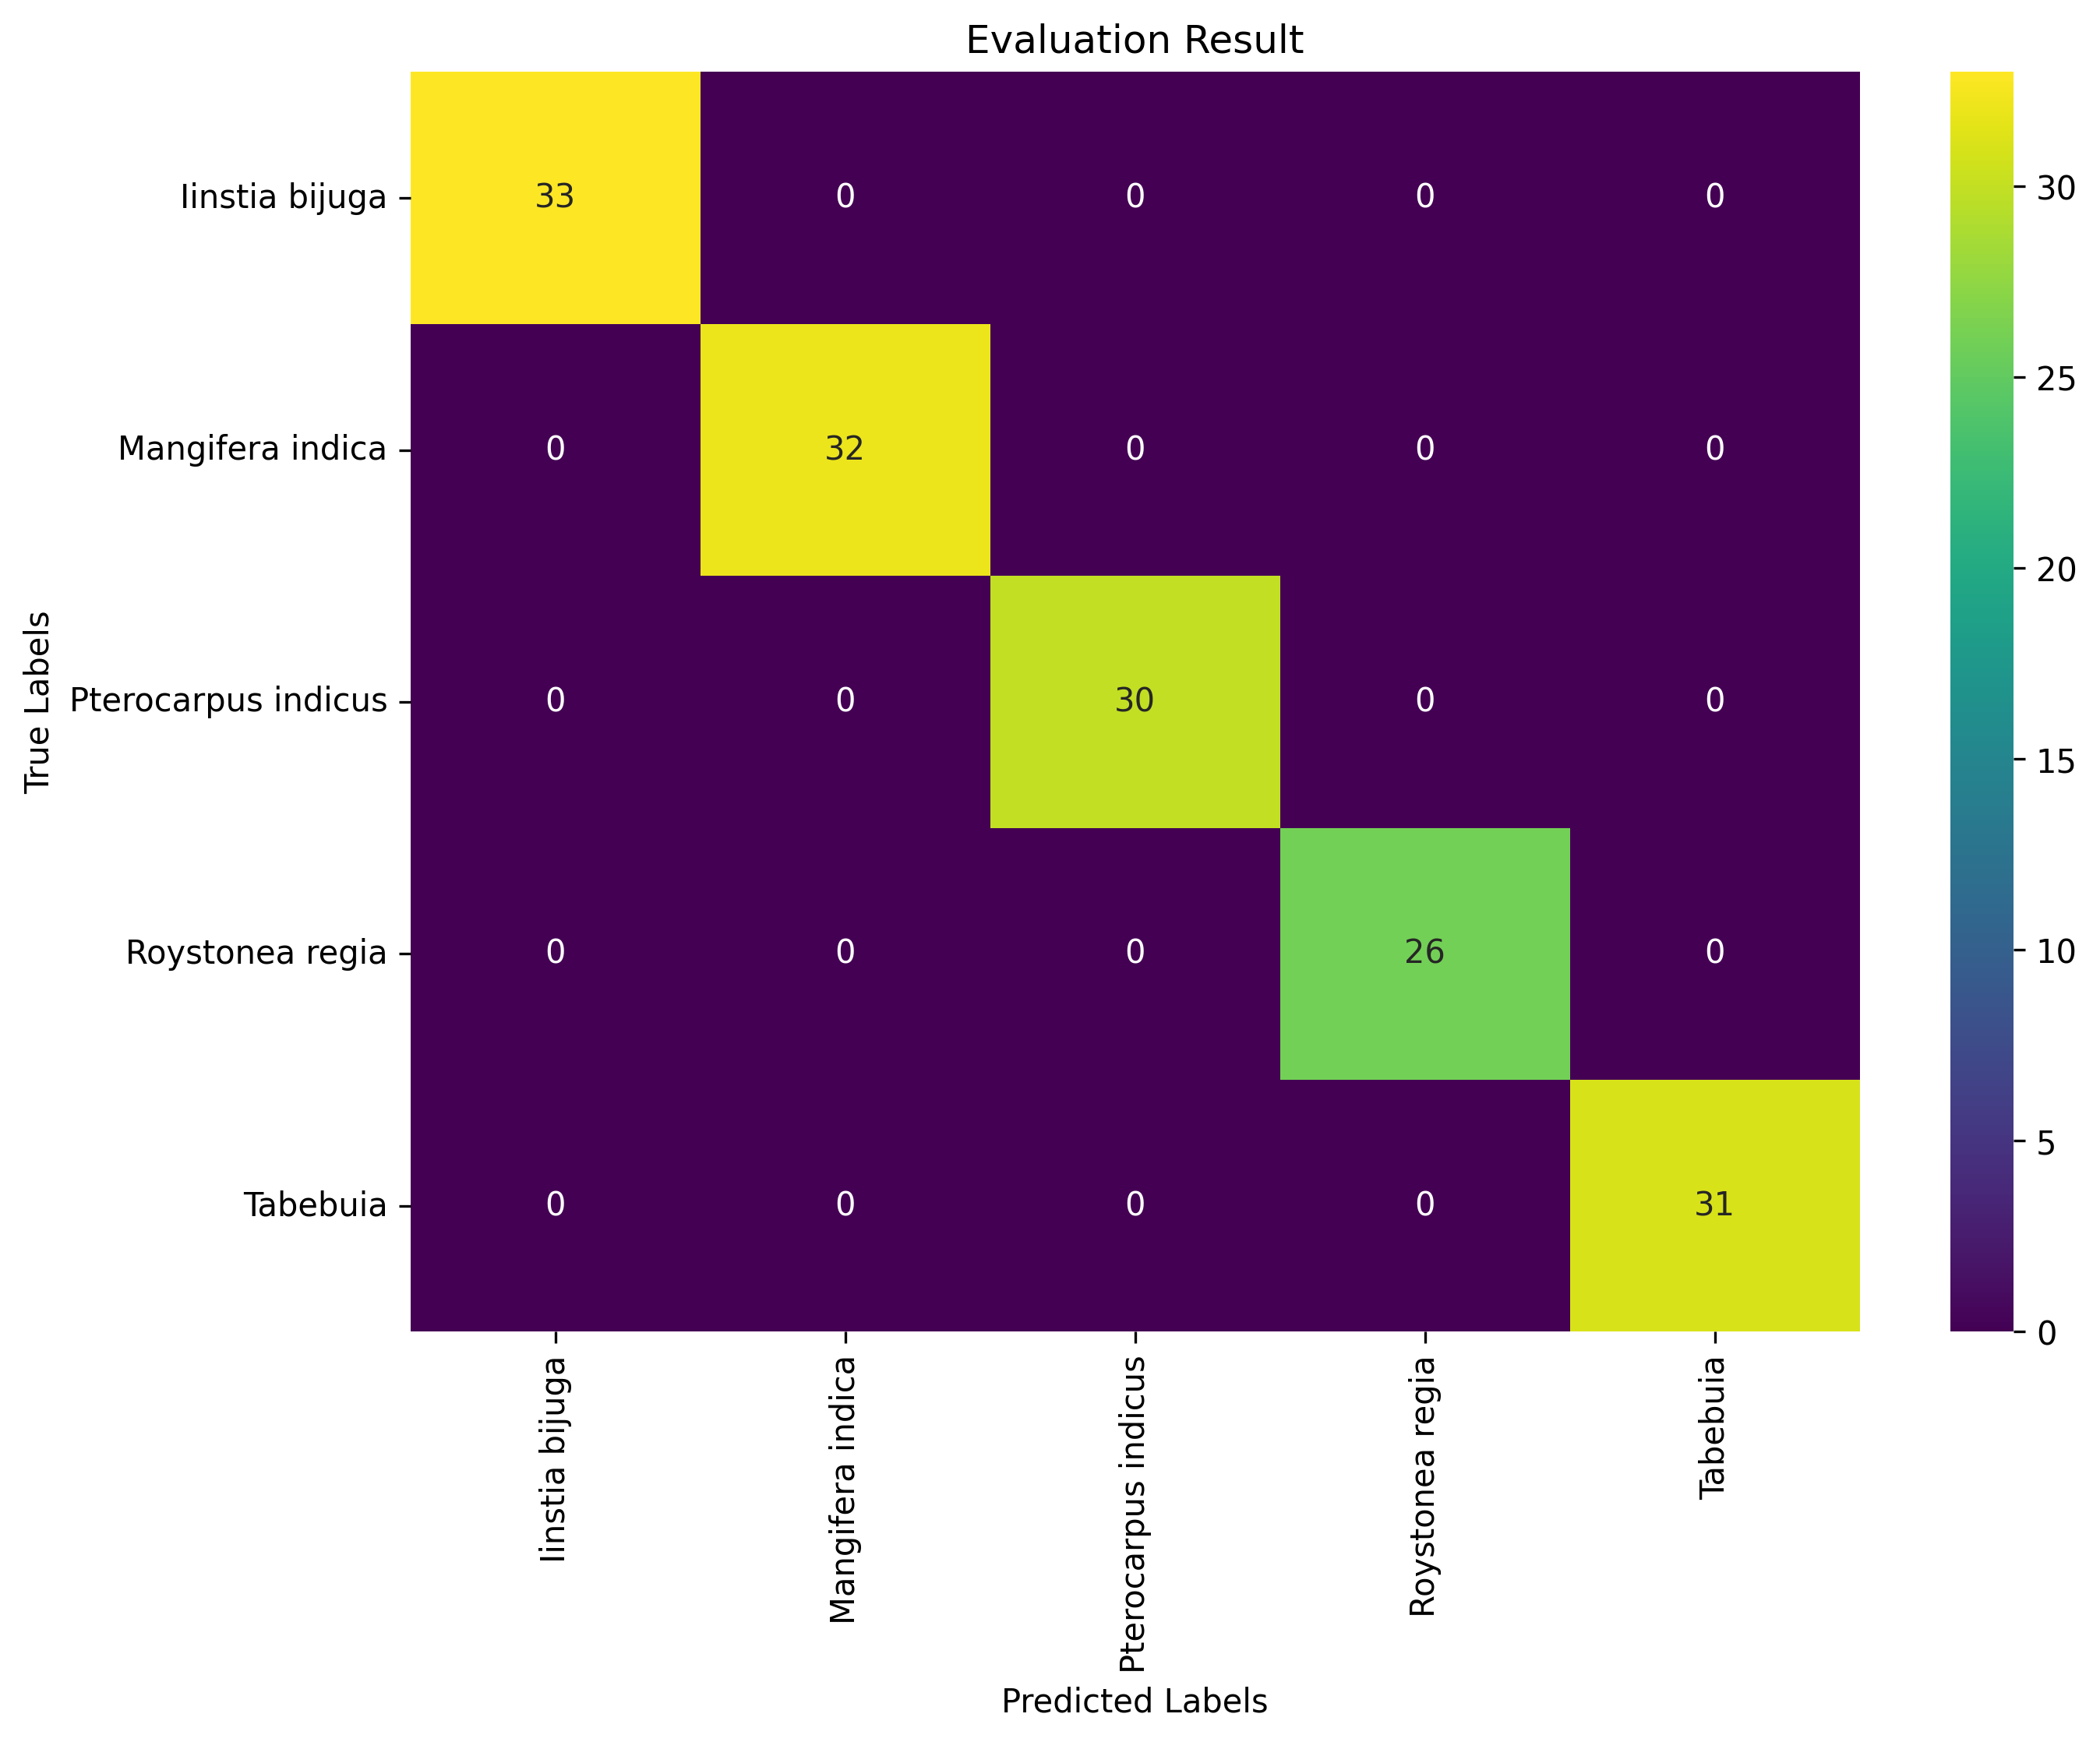
- confusion_matrix.png +0 -0
- eval_results.json +11 -11
- integrated_gradients_grid.jpg +3 -0
- model.safetensors +1 -1
- train_and_eval.jpg +0 -0
- train_results.json +6 -6
- trainer_state.json +284 -209
- training_args.bin +1 -1
.gitattributes
CHANGED
|
@@ -33,3 +33,4 @@ saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
|
|
|
|
|
| 33 |
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
integrated_gradients_grid.jpg filter=lfs diff=lfs merge=lfs -text
|
README.md
CHANGED
|
@@ -4,8 +4,6 @@ license: apache-2.0
|
|
| 4 |
base_model: google/vit-base-patch16-224
|
| 5 |
tags:
|
| 6 |
- generated_from_trainer
|
| 7 |
-
datasets:
|
| 8 |
-
- imagefolder
|
| 9 |
metrics:
|
| 10 |
- precision
|
| 11 |
- recall
|
|
@@ -13,29 +11,7 @@ metrics:
|
|
| 13 |
- accuracy
|
| 14 |
model-index:
|
| 15 |
- name: vit-base-patch16-224-finetuned-barkley
|
| 16 |
-
results:
|
| 17 |
-
- task:
|
| 18 |
-
name: Image Classification
|
| 19 |
-
type: image-classification
|
| 20 |
-
dataset:
|
| 21 |
-
name: imagefolder
|
| 22 |
-
type: imagefolder
|
| 23 |
-
config: default
|
| 24 |
-
split: train
|
| 25 |
-
args: default
|
| 26 |
-
metrics:
|
| 27 |
-
- name: Precision
|
| 28 |
-
type: precision
|
| 29 |
-
value: 0.9936145510835913
|
| 30 |
-
- name: Recall
|
| 31 |
-
type: recall
|
| 32 |
-
value: 0.993421052631579
|
| 33 |
-
- name: F1
|
| 34 |
-
type: f1
|
| 35 |
-
value: 0.993419541966282
|
| 36 |
-
- name: Accuracy
|
| 37 |
-
type: accuracy
|
| 38 |
-
value: 0.9939393939393939
|
| 39 |
---
|
| 40 |
|
| 41 |
<!-- This model card has been generated automatically according to the information the Trainer had access to. You
|
|
@@ -43,15 +19,15 @@ should probably proofread and complete it, then remove this comment. -->
|
|
| 43 |
|
| 44 |
# vit-base-patch16-224-finetuned-barkley
|
| 45 |
|
| 46 |
-
This model is a fine-tuned version of [google/vit-base-patch16-224](https://huggingface.co/google/vit-base-patch16-224) on
|
| 47 |
It achieves the following results on the evaluation set:
|
| 48 |
-
- Loss: 0.
|
| 49 |
-
- Precision:
|
| 50 |
-
- Recall:
|
| 51 |
-
- F1:
|
| 52 |
-
- Accuracy:
|
| 53 |
-
- Top1 Accuracy:
|
| 54 |
-
- Error Rate: 0.
|
| 55 |
|
| 56 |
## Model description
|
| 57 |
|
|
@@ -70,10 +46,12 @@ More information needed
|
|
| 70 |
### Training hyperparameters
|
| 71 |
|
| 72 |
The following hyperparameters were used during training:
|
| 73 |
-
- learning_rate: 0.
|
| 74 |
-
- train_batch_size:
|
| 75 |
-
- eval_batch_size:
|
| 76 |
- seed: 42
|
|
|
|
|
|
|
| 77 |
- optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
|
| 78 |
- lr_scheduler_type: linear
|
| 79 |
- lr_scheduler_warmup_ratio: 0.1
|
|
@@ -84,25 +62,28 @@ The following hyperparameters were used during training:
|
|
| 84 |
|
| 85 |
| Training Loss | Epoch | Step | Validation Loss | Precision | Recall | F1 | Accuracy | Top1 Accuracy | Error Rate |
|
| 86 |
|:-------------:|:-----:|:----:|:---------------:|:---------:|:------:|:------:|:--------:|:-------------:|:----------:|
|
| 87 |
-
| 1.
|
| 88 |
-
| 1.
|
| 89 |
-
| 1.
|
| 90 |
-
| 0.
|
| 91 |
-
| 0.
|
| 92 |
-
| 0.
|
| 93 |
-
| 0.
|
| 94 |
-
| 0.
|
| 95 |
-
| 0.
|
| 96 |
-
| 0.
|
| 97 |
-
| 0.
|
| 98 |
-
| 0.
|
| 99 |
-
| 0.
|
| 100 |
-
| 0.
|
|
|
|
|
|
|
|
|
|
| 101 |
|
| 102 |
|
| 103 |
### Framework versions
|
| 104 |
|
| 105 |
-
- Transformers 4.
|
| 106 |
- Pytorch 2.3.1+cu121
|
| 107 |
- Datasets 3.0.1
|
| 108 |
-
- Tokenizers 0.
|
|
|
|
| 4 |
base_model: google/vit-base-patch16-224
|
| 5 |
tags:
|
| 6 |
- generated_from_trainer
|
|
|
|
|
|
|
| 7 |
metrics:
|
| 8 |
- precision
|
| 9 |
- recall
|
|
|
|
| 11 |
- accuracy
|
| 12 |
model-index:
|
| 13 |
- name: vit-base-patch16-224-finetuned-barkley
|
| 14 |
+
results: []
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 15 |
---
|
| 16 |
|
| 17 |
<!-- This model card has been generated automatically according to the information the Trainer had access to. You
|
|
|
|
| 19 |
|
| 20 |
# vit-base-patch16-224-finetuned-barkley
|
| 21 |
|
| 22 |
+
This model is a fine-tuned version of [google/vit-base-patch16-224](https://huggingface.co/google/vit-base-patch16-224) on an unknown dataset.
|
| 23 |
It achieves the following results on the evaluation set:
|
| 24 |
+
- Loss: 0.0036
|
| 25 |
+
- Precision: 1.0
|
| 26 |
+
- Recall: 1.0
|
| 27 |
+
- F1: 1.0
|
| 28 |
+
- Accuracy: 1.0
|
| 29 |
+
- Top1 Accuracy: 1.0
|
| 30 |
+
- Error Rate: 0.0
|
| 31 |
|
| 32 |
## Model description
|
| 33 |
|
|
|
|
| 46 |
### Training hyperparameters
|
| 47 |
|
| 48 |
The following hyperparameters were used during training:
|
| 49 |
+
- learning_rate: 0.0005
|
| 50 |
+
- train_batch_size: 8
|
| 51 |
+
- eval_batch_size: 8
|
| 52 |
- seed: 42
|
| 53 |
+
- gradient_accumulation_steps: 4
|
| 54 |
+
- total_train_batch_size: 32
|
| 55 |
- optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
|
| 56 |
- lr_scheduler_type: linear
|
| 57 |
- lr_scheduler_warmup_ratio: 0.1
|
|
|
|
| 62 |
|
| 63 |
| Training Loss | Epoch | Step | Validation Loss | Precision | Recall | F1 | Accuracy | Top1 Accuracy | Error Rate |
|
| 64 |
|:-------------:|:-----:|:----:|:---------------:|:---------:|:------:|:------:|:--------:|:-------------:|:----------:|
|
| 65 |
+
| 1.6093 | 1.0 | 38 | 1.4340 | 0.4769 | 0.4342 | 0.4066 | 0.4149 | 0.4342 | 0.5851 |
|
| 66 |
+
| 1.2908 | 2.0 | 76 | 1.1747 | 0.6587 | 0.6118 | 0.6160 | 0.6161 | 0.6118 | 0.3839 |
|
| 67 |
+
| 1.0409 | 3.0 | 114 | 0.9174 | 0.7382 | 0.7303 | 0.7293 | 0.7425 | 0.7303 | 0.2575 |
|
| 68 |
+
| 0.781 | 4.0 | 152 | 0.6528 | 0.8632 | 0.8618 | 0.8622 | 0.8650 | 0.8618 | 0.1350 |
|
| 69 |
+
| 0.5429 | 5.0 | 190 | 0.4112 | 0.9417 | 0.9408 | 0.9405 | 0.9443 | 0.9408 | 0.0557 |
|
| 70 |
+
| 0.328 | 6.0 | 228 | 0.2229 | 0.9809 | 0.9803 | 0.9802 | 0.9811 | 0.9803 | 0.0189 |
|
| 71 |
+
| 0.1837 | 7.0 | 266 | 0.1181 | 0.9871 | 0.9868 | 0.9868 | 0.9878 | 0.9868 | 0.0122 |
|
| 72 |
+
| 0.1131 | 8.0 | 304 | 0.0680 | 0.9937 | 0.9934 | 0.9934 | 0.9944 | 0.9934 | 0.0056 |
|
| 73 |
+
| 0.0526 | 9.0 | 342 | 0.0387 | 0.9937 | 0.9934 | 0.9934 | 0.9944 | 0.9934 | 0.0056 |
|
| 74 |
+
| 0.0283 | 10.0 | 380 | 0.0328 | 0.9873 | 0.9868 | 0.9869 | 0.9878 | 0.9868 | 0.0122 |
|
| 75 |
+
| 0.019 | 11.0 | 418 | 0.0224 | 0.9873 | 0.9868 | 0.9868 | 0.9889 | 0.9868 | 0.0111 |
|
| 76 |
+
| 0.0148 | 12.0 | 456 | 0.0201 | 0.9873 | 0.9868 | 0.9868 | 0.9889 | 0.9868 | 0.0111 |
|
| 77 |
+
| 0.0095 | 13.0 | 494 | 0.0396 | 0.9871 | 0.9868 | 0.9868 | 0.9878 | 0.9868 | 0.0122 |
|
| 78 |
+
| 0.007 | 14.0 | 532 | 0.0048 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 0.0 |
|
| 79 |
+
| 0.011 | 15.0 | 570 | 0.0036 | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 | 0.0 |
|
| 80 |
+
| 0.0071 | 16.0 | 608 | 0.0092 | 0.9936 | 0.9934 | 0.9934 | 0.9941 | 0.9934 | 0.0059 |
|
| 81 |
+
| 0.0103 | 17.0 | 646 | 0.0148 | 0.9936 | 0.9934 | 0.9934 | 0.9944 | 0.9934 | 0.0056 |
|
| 82 |
|
| 83 |
|
| 84 |
### Framework versions
|
| 85 |
|
| 86 |
+
- Transformers 4.44.2
|
| 87 |
- Pytorch 2.3.1+cu121
|
| 88 |
- Datasets 3.0.1
|
| 89 |
+
- Tokenizers 0.19.1
|
all_results.json
CHANGED
|
@@ -1,19 +1,18 @@
|
|
| 1 |
{
|
| 2 |
-
"epoch":
|
| 3 |
-
"eval_accuracy":
|
| 4 |
-
"eval_error_rate": 0.
|
| 5 |
-
"eval_f1":
|
| 6 |
-
"eval_loss": 0.
|
| 7 |
-
"
|
| 8 |
-
"
|
| 9 |
-
"
|
| 10 |
-
"
|
| 11 |
-
"
|
| 12 |
-
"
|
| 13 |
-
"
|
| 14 |
-
"
|
| 15 |
-
"
|
| 16 |
-
"
|
| 17 |
-
"
|
| 18 |
-
"train_steps_per_second": 0.105
|
| 19 |
}
|
|
|
|
| 1 |
{
|
| 2 |
+
"epoch": 17.0,
|
| 3 |
+
"eval_accuracy": 1.0,
|
| 4 |
+
"eval_error_rate": 0.0,
|
| 5 |
+
"eval_f1": 1.0,
|
| 6 |
+
"eval_loss": 0.003647729055956006,
|
| 7 |
+
"eval_precision": 1.0,
|
| 8 |
+
"eval_recall": 1.0,
|
| 9 |
+
"eval_runtime": 63.8492,
|
| 10 |
+
"eval_samples_per_second": 2.381,
|
| 11 |
+
"eval_steps_per_second": 0.298,
|
| 12 |
+
"eval_top1_accuracy": 1.0,
|
| 13 |
+
"total_flos": 1.601957481669329e+18,
|
| 14 |
+
"train_loss": 0.3558414801263219,
|
| 15 |
+
"train_runtime": 14288.2591,
|
| 16 |
+
"train_samples_per_second": 2.553,
|
| 17 |
+
"train_steps_per_second": 0.08
|
|
|
|
| 18 |
}
|
classification_report.png
CHANGED
|

|
config.json
CHANGED
|
@@ -34,5 +34,5 @@
|
|
| 34 |
"problem_type": "single_label_classification",
|
| 35 |
"qkv_bias": true,
|
| 36 |
"torch_dtype": "float32",
|
| 37 |
-
"transformers_version": "4.
|
| 38 |
}
|
|
|
|
| 34 |
"problem_type": "single_label_classification",
|
| 35 |
"qkv_bias": true,
|
| 36 |
"torch_dtype": "float32",
|
| 37 |
+
"transformers_version": "4.44.2"
|
| 38 |
}
|
confusion_matrix.png
CHANGED
|

|
eval_results.json
CHANGED
|
@@ -1,13 +1,13 @@
|
|
| 1 |
{
|
| 2 |
-
"epoch":
|
| 3 |
-
"eval_accuracy":
|
| 4 |
-
"eval_error_rate": 0.
|
| 5 |
-
"eval_f1":
|
| 6 |
-
"eval_loss": 0.
|
| 7 |
-
"eval_precision":
|
| 8 |
-
"eval_recall":
|
| 9 |
-
"eval_runtime":
|
| 10 |
-
"eval_samples_per_second": 2.
|
| 11 |
-
"eval_steps_per_second": 0.
|
| 12 |
-
"eval_top1_accuracy":
|
| 13 |
}
|
|
|
|
| 1 |
{
|
| 2 |
+
"epoch": 17.0,
|
| 3 |
+
"eval_accuracy": 1.0,
|
| 4 |
+
"eval_error_rate": 0.0,
|
| 5 |
+
"eval_f1": 1.0,
|
| 6 |
+
"eval_loss": 0.003647729055956006,
|
| 7 |
+
"eval_precision": 1.0,
|
| 8 |
+
"eval_recall": 1.0,
|
| 9 |
+
"eval_runtime": 63.8492,
|
| 10 |
+
"eval_samples_per_second": 2.381,
|
| 11 |
+
"eval_steps_per_second": 0.298,
|
| 12 |
+
"eval_top1_accuracy": 1.0
|
| 13 |
}
|
integrated_gradients_grid.jpg
ADDED

|
Git LFS Details
|
model.safetensors
CHANGED
|
@@ -1,3 +1,3 @@
|
|
| 1 |
version https://git-lfs.github.com/spec/v1
|
| 2 |
-
oid sha256:
|
| 3 |
size 343233204
|
|
|
|
| 1 |
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:095e519b8fe95230c057af31cba64f9087271dc9aea96438255c92d1b61d4810
|
| 3 |
size 343233204
|
train_and_eval.jpg
CHANGED

|

|
train_results.json
CHANGED
|
@@ -1,8 +1,8 @@
|
|
| 1 |
{
|
| 2 |
-
"epoch":
|
| 3 |
-
"total_flos": 1.
|
| 4 |
-
"train_loss": 0.
|
| 5 |
-
"train_runtime":
|
| 6 |
-
"train_samples_per_second":
|
| 7 |
-
"train_steps_per_second": 0.
|
| 8 |
}
|
|
|
|
| 1 |
{
|
| 2 |
+
"epoch": 17.0,
|
| 3 |
+
"total_flos": 1.601957481669329e+18,
|
| 4 |
+
"train_loss": 0.3558414801263219,
|
| 5 |
+
"train_runtime": 14288.2591,
|
| 6 |
+
"train_samples_per_second": 2.553,
|
| 7 |
+
"train_steps_per_second": 0.08
|
| 8 |
}
|
trainer_state.json
CHANGED
|
@@ -1,374 +1,449 @@
|
|
| 1 |
{
|
| 2 |
-
"best_metric": 0.
|
| 3 |
-
"best_model_checkpoint": "vit-base-patch16-224-finetuned-barkley\\checkpoint-
|
| 4 |
-
"epoch":
|
| 5 |
"eval_steps": 500,
|
| 6 |
-
"global_step":
|
| 7 |
"is_hyper_param_search": false,
|
| 8 |
"is_local_process_zero": true,
|
| 9 |
"is_world_process_zero": true,
|
| 10 |
"log_history": [
|
| 11 |
{
|
| 12 |
"epoch": 1.0,
|
| 13 |
-
"train_accuracy": 0.
|
| 14 |
},
|
| 15 |
{
|
| 16 |
"epoch": 1.0,
|
| 17 |
-
"grad_norm":
|
| 18 |
-
"learning_rate":
|
| 19 |
-
"loss": 1.
|
| 20 |
"step": 38
|
| 21 |
},
|
| 22 |
{
|
| 23 |
"epoch": 1.0,
|
| 24 |
-
"eval_accuracy": 0.
|
| 25 |
-
"eval_error_rate": 0.
|
| 26 |
-
"eval_f1": 0.
|
| 27 |
-
"eval_loss": 1.
|
| 28 |
-
"eval_precision": 0.
|
| 29 |
-
"eval_recall": 0.
|
| 30 |
-
"eval_runtime":
|
| 31 |
-
"eval_samples_per_second":
|
| 32 |
-
"eval_steps_per_second": 0.
|
| 33 |
-
"eval_top1_accuracy": 0.
|
| 34 |
"step": 38
|
| 35 |
},
|
| 36 |
{
|
| 37 |
"epoch": 2.0,
|
| 38 |
-
"train_accuracy": 0.
|
| 39 |
},
|
| 40 |
{
|
| 41 |
"epoch": 2.0,
|
| 42 |
-
"grad_norm": 6.
|
| 43 |
-
"learning_rate": 2.
|
| 44 |
-
"loss": 1.
|
| 45 |
"step": 76
|
| 46 |
},
|
| 47 |
{
|
| 48 |
"epoch": 2.0,
|
| 49 |
-
"eval_accuracy": 0.
|
| 50 |
-
"eval_error_rate": 0.
|
| 51 |
-
"eval_f1": 0.
|
| 52 |
-
"eval_loss": 1.
|
| 53 |
-
"eval_precision": 0.
|
| 54 |
-
"eval_recall": 0.
|
| 55 |
-
"eval_runtime":
|
| 56 |
-
"eval_samples_per_second": 2.
|
| 57 |
-
"eval_steps_per_second": 0.
|
| 58 |
-
"eval_top1_accuracy": 0.
|
| 59 |
"step": 76
|
| 60 |
},
|
| 61 |
{
|
| 62 |
"epoch": 3.0,
|
| 63 |
-
"train_accuracy": 0.
|
| 64 |
},
|
| 65 |
{
|
| 66 |
"epoch": 3.0,
|
| 67 |
-
"grad_norm": 5.
|
| 68 |
-
"learning_rate":
|
| 69 |
-
"loss": 1.
|
| 70 |
"step": 114
|
| 71 |
},
|
| 72 |
{
|
| 73 |
"epoch": 3.0,
|
| 74 |
-
"eval_accuracy": 0.
|
| 75 |
-
"eval_error_rate": 0.
|
| 76 |
-
"eval_f1": 0.
|
| 77 |
-
"eval_loss":
|
| 78 |
-
"eval_precision": 0.
|
| 79 |
-
"eval_recall": 0.
|
| 80 |
-
"eval_runtime":
|
| 81 |
-
"eval_samples_per_second":
|
| 82 |
-
"eval_steps_per_second": 0.
|
| 83 |
-
"eval_top1_accuracy": 0.
|
| 84 |
"step": 114
|
| 85 |
},
|
| 86 |
{
|
| 87 |
"epoch": 4.0,
|
| 88 |
-
"train_accuracy": 0.
|
| 89 |
},
|
| 90 |
{
|
| 91 |
"epoch": 4.0,
|
| 92 |
-
"grad_norm":
|
| 93 |
-
"learning_rate":
|
| 94 |
-
"loss": 0.
|
| 95 |
"step": 152
|
| 96 |
},
|
| 97 |
{
|
| 98 |
"epoch": 4.0,
|
| 99 |
-
"eval_accuracy": 0.
|
| 100 |
-
"eval_error_rate": 0.
|
| 101 |
-
"eval_f1": 0.
|
| 102 |
-
"eval_loss": 0.
|
| 103 |
-
"eval_precision": 0.
|
| 104 |
-
"eval_recall": 0.
|
| 105 |
-
"eval_runtime":
|
| 106 |
-
"eval_samples_per_second":
|
| 107 |
-
"eval_steps_per_second": 0.
|
| 108 |
-
"eval_top1_accuracy": 0.
|
| 109 |
"step": 152
|
| 110 |
},
|
| 111 |
{
|
| 112 |
"epoch": 5.0,
|
| 113 |
-
"train_accuracy": 0.
|
| 114 |
},
|
| 115 |
{
|
| 116 |
"epoch": 5.0,
|
| 117 |
-
"grad_norm":
|
| 118 |
-
"learning_rate":
|
| 119 |
-
"loss": 0.
|
| 120 |
"step": 190
|
| 121 |
},
|
| 122 |
{
|
| 123 |
"epoch": 5.0,
|
| 124 |
-
"eval_accuracy": 0.
|
| 125 |
-
"eval_error_rate": 0.
|
| 126 |
-
"eval_f1": 0.
|
| 127 |
-
"eval_loss": 0.
|
| 128 |
-
"eval_precision": 0.
|
| 129 |
-
"eval_recall": 0.
|
| 130 |
-
"eval_runtime":
|
| 131 |
-
"eval_samples_per_second":
|
| 132 |
-
"eval_steps_per_second": 0.
|
| 133 |
-
"eval_top1_accuracy": 0.
|
| 134 |
"step": 190
|
| 135 |
},
|
| 136 |
{
|
| 137 |
"epoch": 6.0,
|
| 138 |
-
"train_accuracy": 0.
|
| 139 |
},
|
| 140 |
{
|
| 141 |
"epoch": 6.0,
|
| 142 |
-
"grad_norm":
|
| 143 |
-
"learning_rate":
|
| 144 |
-
"loss": 0.
|
| 145 |
"step": 228
|
| 146 |
},
|
| 147 |
{
|
| 148 |
"epoch": 6.0,
|
| 149 |
-
"eval_accuracy": 0.
|
| 150 |
-
"eval_error_rate": 0.
|
| 151 |
-
"eval_f1": 0.
|
| 152 |
-
"eval_loss": 0.
|
| 153 |
-
"eval_precision": 0.
|
| 154 |
-
"eval_recall": 0.
|
| 155 |
-
"eval_runtime":
|
| 156 |
-
"eval_samples_per_second": 2.
|
| 157 |
-
"eval_steps_per_second": 0.
|
| 158 |
-
"eval_top1_accuracy": 0.
|
| 159 |
"step": 228
|
| 160 |
},
|
| 161 |
{
|
| 162 |
"epoch": 7.0,
|
| 163 |
-
"train_accuracy": 0.
|
| 164 |
},
|
| 165 |
{
|
| 166 |
"epoch": 7.0,
|
| 167 |
-
"grad_norm":
|
| 168 |
-
"learning_rate":
|
| 169 |
-
"loss": 0.
|
| 170 |
"step": 266
|
| 171 |
},
|
| 172 |
{
|
| 173 |
"epoch": 7.0,
|
| 174 |
-
"eval_accuracy": 0.
|
| 175 |
-
"eval_error_rate": 0.
|
| 176 |
-
"eval_f1": 0.
|
| 177 |
-
"eval_loss": 0.
|
| 178 |
-
"eval_precision": 0.
|
| 179 |
"eval_recall": 0.9868421052631579,
|
| 180 |
-
"eval_runtime":
|
| 181 |
-
"eval_samples_per_second": 2.
|
| 182 |
-
"eval_steps_per_second": 0.
|
| 183 |
"eval_top1_accuracy": 0.9868421052631579,
|
| 184 |
"step": 266
|
| 185 |
},
|
| 186 |
{
|
| 187 |
"epoch": 8.0,
|
| 188 |
-
"train_accuracy": 0.
|
| 189 |
},
|
| 190 |
{
|
| 191 |
"epoch": 8.0,
|
| 192 |
-
"grad_norm":
|
| 193 |
-
"learning_rate":
|
| 194 |
-
"loss": 0.
|
| 195 |
"step": 304
|
| 196 |
},
|
| 197 |
{
|
| 198 |
"epoch": 8.0,
|
| 199 |
-
"eval_accuracy": 0.
|
| 200 |
-
"eval_error_rate": 0.
|
| 201 |
-
"eval_f1": 0.
|
| 202 |
-
"eval_loss": 0.
|
| 203 |
-
"eval_precision": 0.
|
| 204 |
-
"eval_recall": 0.
|
| 205 |
-
"eval_runtime":
|
| 206 |
-
"eval_samples_per_second": 2.
|
| 207 |
-
"eval_steps_per_second": 0.
|
| 208 |
-
"eval_top1_accuracy": 0.
|
| 209 |
"step": 304
|
| 210 |
},
|
| 211 |
{
|
| 212 |
"epoch": 9.0,
|
| 213 |
-
"train_accuracy": 0.
|
| 214 |
},
|
| 215 |
{
|
| 216 |
"epoch": 9.0,
|
| 217 |
-
"grad_norm": 0.
|
| 218 |
-
"learning_rate":
|
| 219 |
-
"loss": 0.
|
| 220 |
"step": 342
|
| 221 |
},
|
| 222 |
{
|
| 223 |
"epoch": 9.0,
|
| 224 |
-
"eval_accuracy": 0.
|
| 225 |
-
"eval_error_rate": 0.
|
| 226 |
-
"eval_f1": 0.
|
| 227 |
-
"eval_loss": 0.
|
| 228 |
-
"eval_precision": 0.
|
| 229 |
-
"eval_recall": 0.
|
| 230 |
-
"eval_runtime": 62.
|
| 231 |
-
"eval_samples_per_second": 2.
|
| 232 |
-
"eval_steps_per_second": 0.
|
| 233 |
-
"eval_top1_accuracy": 0.
|
| 234 |
"step": 342
|
| 235 |
},
|
| 236 |
{
|
| 237 |
"epoch": 10.0,
|
| 238 |
-
"train_accuracy": 0.
|
| 239 |
},
|
| 240 |
{
|
| 241 |
"epoch": 10.0,
|
| 242 |
-
"grad_norm": 0.
|
| 243 |
-
"learning_rate": 1.
|
| 244 |
-
"loss": 0.
|
| 245 |
"step": 380
|
| 246 |
},
|
| 247 |
{
|
| 248 |
"epoch": 10.0,
|
| 249 |
-
"eval_accuracy": 0.
|
| 250 |
-
"eval_error_rate": 0.
|
| 251 |
-
"eval_f1": 0.
|
| 252 |
-
"eval_loss": 0.
|
| 253 |
-
"eval_precision": 0.
|
| 254 |
-
"eval_recall": 0.
|
| 255 |
-
"eval_runtime":
|
| 256 |
-
"eval_samples_per_second": 2.
|
| 257 |
-
"eval_steps_per_second": 0.
|
| 258 |
-
"eval_top1_accuracy": 0.
|
| 259 |
"step": 380
|
| 260 |
},
|
| 261 |
{
|
| 262 |
"epoch": 11.0,
|
| 263 |
-
"train_accuracy": 0.
|
| 264 |
},
|
| 265 |
{
|
| 266 |
"epoch": 11.0,
|
| 267 |
-
"grad_norm": 0.
|
| 268 |
-
"learning_rate": 1.
|
| 269 |
-
"loss": 0.
|
| 270 |
"step": 418
|
| 271 |
},
|
| 272 |
{
|
| 273 |
"epoch": 11.0,
|
| 274 |
-
"eval_accuracy": 0.
|
| 275 |
-
"eval_error_rate": 0.
|
| 276 |
-
"eval_f1": 0.
|
| 277 |
-
"eval_loss": 0.
|
| 278 |
-
"eval_precision": 0.
|
| 279 |
-
"eval_recall": 0.
|
| 280 |
-
"eval_runtime":
|
| 281 |
-
"eval_samples_per_second":
|
| 282 |
-
"eval_steps_per_second": 0.
|
| 283 |
-
"eval_top1_accuracy": 0.
|
| 284 |
"step": 418
|
| 285 |
},
|
| 286 |
{
|
| 287 |
"epoch": 12.0,
|
| 288 |
-
"train_accuracy": 0.
|
| 289 |
},
|
| 290 |
{
|
| 291 |
"epoch": 12.0,
|
| 292 |
-
"grad_norm":
|
| 293 |
-
"learning_rate": 1.
|
| 294 |
-
"loss": 0.
|
| 295 |
"step": 456
|
| 296 |
},
|
| 297 |
{
|
| 298 |
"epoch": 12.0,
|
| 299 |
-
"eval_accuracy": 0.
|
| 300 |
-
"eval_error_rate": 0.
|
| 301 |
-
"eval_f1": 0.
|
| 302 |
-
"eval_loss": 0.
|
| 303 |
-
"eval_precision": 0.
|
| 304 |
-
"eval_recall": 0.
|
| 305 |
-
"eval_runtime":
|
| 306 |
-
"eval_samples_per_second": 2.
|
| 307 |
-
"eval_steps_per_second": 0.
|
| 308 |
-
"eval_top1_accuracy": 0.
|
| 309 |
"step": 456
|
| 310 |
},
|
| 311 |
{
|
| 312 |
"epoch": 13.0,
|
| 313 |
-
"train_accuracy": 0.
|
| 314 |
},
|
| 315 |
{
|
| 316 |
"epoch": 13.0,
|
| 317 |
-
"grad_norm": 0.
|
| 318 |
-
"learning_rate": 1.
|
| 319 |
-
"loss": 0.
|
| 320 |
"step": 494
|
| 321 |
},
|
| 322 |
{
|
| 323 |
"epoch": 13.0,
|
| 324 |
-
"eval_accuracy": 0.
|
| 325 |
-
"eval_error_rate": 0.
|
| 326 |
-
"eval_f1": 0.
|
| 327 |
-
"eval_loss": 0.
|
| 328 |
-
"eval_precision": 0.
|
| 329 |
-
"eval_recall": 0.
|
| 330 |
-
"eval_runtime":
|
| 331 |
-
"eval_samples_per_second": 2.
|
| 332 |
-
"eval_steps_per_second": 0.
|
| 333 |
-
"eval_top1_accuracy": 0.
|
| 334 |
"step": 494
|
| 335 |
},
|
| 336 |
{
|
| 337 |
"epoch": 14.0,
|
| 338 |
-
"train_accuracy": 0.
|
| 339 |
},
|
| 340 |
{
|
| 341 |
"epoch": 14.0,
|
| 342 |
-
"grad_norm": 0.
|
| 343 |
-
"learning_rate": 1.
|
| 344 |
-
"loss": 0.
|
| 345 |
"step": 532
|
| 346 |
},
|
| 347 |
{
|
| 348 |
"epoch": 14.0,
|
| 349 |
-
"eval_accuracy":
|
| 350 |
-
"eval_error_rate": 0.
|
| 351 |
-
"eval_f1":
|
| 352 |
-
"eval_loss": 0.
|
| 353 |
-
"eval_precision":
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 354 |
"eval_recall": 0.993421052631579,
|
| 355 |
-
"eval_runtime":
|
| 356 |
-
"eval_samples_per_second": 2.
|
| 357 |
-
"eval_steps_per_second": 0.
|
| 358 |
"eval_top1_accuracy": 0.993421052631579,
|
| 359 |
-
"step":
|
| 360 |
},
|
| 361 |
{
|
| 362 |
-
"epoch":
|
| 363 |
-
"
|
| 364 |
-
|
| 365 |
-
|
| 366 |
-
"
|
| 367 |
-
"
|
| 368 |
-
"
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 369 |
}
|
| 370 |
],
|
| 371 |
-
"logging_steps":
|
| 372 |
"max_steps": 1140,
|
| 373 |
"num_input_tokens_seen": 0,
|
| 374 |
"num_train_epochs": 30,
|
|
@@ -376,11 +451,11 @@
|
|
| 376 |
"stateful_callbacks": {
|
| 377 |
"EarlyStoppingCallback": {
|
| 378 |
"args": {
|
| 379 |
-
"early_stopping_patience":
|
| 380 |
"early_stopping_threshold": 0.0
|
| 381 |
},
|
| 382 |
"attributes": {
|
| 383 |
-
"early_stopping_patience_counter":
|
| 384 |
}
|
| 385 |
},
|
| 386 |
"TrainerControl": {
|
|
@@ -394,8 +469,8 @@
|
|
| 394 |
"attributes": {}
|
| 395 |
}
|
| 396 |
},
|
| 397 |
-
"total_flos": 1.
|
| 398 |
-
"train_batch_size":
|
| 399 |
"trial_name": null,
|
| 400 |
"trial_params": null
|
| 401 |
}
|
|
|
|
| 1 |
{
|
| 2 |
+
"best_metric": 0.003647729055956006,
|
| 3 |
+
"best_model_checkpoint": "vit-base-patch16-224-finetuned-barkley\\checkpoint-570",
|
| 4 |
+
"epoch": 17.0,
|
| 5 |
"eval_steps": 500,
|
| 6 |
+
"global_step": 646,
|
| 7 |
"is_hyper_param_search": false,
|
| 8 |
"is_local_process_zero": true,
|
| 9 |
"is_world_process_zero": true,
|
| 10 |
"log_history": [
|
| 11 |
{
|
| 12 |
"epoch": 1.0,
|
| 13 |
+
"train_accuracy": 0.26398026315789475
|
| 14 |
},
|
| 15 |
{
|
| 16 |
"epoch": 1.0,
|
| 17 |
+
"grad_norm": 6.455413341522217,
|
| 18 |
+
"learning_rate": 2.0914608267470257e-06,
|
| 19 |
+
"loss": 1.6093,
|
| 20 |
"step": 38
|
| 21 |
},
|
| 22 |
{
|
| 23 |
"epoch": 1.0,
|
| 24 |
+
"eval_accuracy": 0.4148818501759678,
|
| 25 |
+
"eval_error_rate": 0.5851181498240322,
|
| 26 |
+
"eval_f1": 0.406583244487493,
|
| 27 |
+
"eval_loss": 1.4340049028396606,
|
| 28 |
+
"eval_precision": 0.47685010008788203,
|
| 29 |
+
"eval_recall": 0.4342105263157895,
|
| 30 |
+
"eval_runtime": 80.0768,
|
| 31 |
+
"eval_samples_per_second": 1.898,
|
| 32 |
+
"eval_steps_per_second": 0.237,
|
| 33 |
+
"eval_top1_accuracy": 0.4342105263157895,
|
| 34 |
"step": 38
|
| 35 |
},
|
| 36 |
{
|
| 37 |
"epoch": 2.0,
|
| 38 |
+
"train_accuracy": 0.5095029239766082
|
| 39 |
},
|
| 40 |
{
|
| 41 |
"epoch": 2.0,
|
| 42 |
+
"grad_norm": 6.083907127380371,
|
| 43 |
+
"learning_rate": 2.365146216752351e-06,
|
| 44 |
+
"loss": 1.2908,
|
| 45 |
"step": 76
|
| 46 |
},
|
| 47 |
{
|
| 48 |
"epoch": 2.0,
|
| 49 |
+
"eval_accuracy": 0.6161337355455003,
|
| 50 |
+
"eval_error_rate": 0.3838662644544997,
|
| 51 |
+
"eval_f1": 0.615989993007031,
|
| 52 |
+
"eval_loss": 1.1747227907180786,
|
| 53 |
+
"eval_precision": 0.6587479462326463,
|
| 54 |
+
"eval_recall": 0.6118421052631579,
|
| 55 |
+
"eval_runtime": 62.2988,
|
| 56 |
+
"eval_samples_per_second": 2.44,
|
| 57 |
+
"eval_steps_per_second": 0.305,
|
| 58 |
+
"eval_top1_accuracy": 0.6118421052631579,
|
| 59 |
"step": 76
|
| 60 |
},
|
| 61 |
{
|
| 62 |
"epoch": 3.0,
|
| 63 |
+
"train_accuracy": 0.7017543859649122
|
| 64 |
},
|
| 65 |
{
|
| 66 |
"epoch": 3.0,
|
| 67 |
+
"grad_norm": 5.073782444000244,
|
| 68 |
+
"learning_rate": 2.8189702123460904e-06,
|
| 69 |
+
"loss": 1.0409,
|
| 70 |
"step": 114
|
| 71 |
},
|
| 72 |
{
|
| 73 |
"epoch": 3.0,
|
| 74 |
+
"eval_accuracy": 0.7424685771744596,
|
| 75 |
+
"eval_error_rate": 0.2575314228255404,
|
| 76 |
+
"eval_f1": 0.7293001164996891,
|
| 77 |
+
"eval_loss": 0.9174113869667053,
|
| 78 |
+
"eval_precision": 0.7381704260651629,
|
| 79 |
+
"eval_recall": 0.7302631578947368,
|
| 80 |
+
"eval_runtime": 63.0328,
|
| 81 |
+
"eval_samples_per_second": 2.411,
|
| 82 |
+
"eval_steps_per_second": 0.301,
|
| 83 |
+
"eval_top1_accuracy": 0.7302631578947368,
|
| 84 |
"step": 114
|
| 85 |
},
|
| 86 |
{
|
| 87 |
"epoch": 4.0,
|
| 88 |
+
"train_accuracy": 0.8172514619883041
|
| 89 |
},
|
| 90 |
{
|
| 91 |
"epoch": 4.0,
|
| 92 |
+
"grad_norm": 4.503601551055908,
|
| 93 |
+
"learning_rate": 3.449473887042014e-06,
|
| 94 |
+
"loss": 0.781,
|
| 95 |
"step": 152
|
| 96 |
},
|
| 97 |
{
|
| 98 |
"epoch": 4.0,
|
| 99 |
+
"eval_accuracy": 0.8650025138260432,
|
| 100 |
+
"eval_error_rate": 0.1349974861739568,
|
| 101 |
+
"eval_f1": 0.862176726467179,
|
| 102 |
+
"eval_loss": 0.6527765989303589,
|
| 103 |
+
"eval_precision": 0.8632378661708033,
|
| 104 |
+
"eval_recall": 0.8618421052631579,
|
| 105 |
+
"eval_runtime": 64.1793,
|
| 106 |
+
"eval_samples_per_second": 2.368,
|
| 107 |
+
"eval_steps_per_second": 0.296,
|
| 108 |
+
"eval_top1_accuracy": 0.8618421052631579,
|
| 109 |
"step": 152
|
| 110 |
},
|
| 111 |
{
|
| 112 |
"epoch": 5.0,
|
| 113 |
+
"train_accuracy": 0.9027777777777778
|
| 114 |
},
|
| 115 |
{
|
| 116 |
"epoch": 5.0,
|
| 117 |
+
"grad_norm": 3.8262150287628174,
|
| 118 |
+
"learning_rate": 4.251851708560589e-06,
|
| 119 |
+
"loss": 0.5429,
|
| 120 |
"step": 190
|
| 121 |
},
|
| 122 |
{
|
| 123 |
"epoch": 5.0,
|
| 124 |
+
"eval_accuracy": 0.9442885872297637,
|
| 125 |
+
"eval_error_rate": 0.05571141277023628,
|
| 126 |
+
"eval_f1": 0.9404774954713644,
|
| 127 |
+
"eval_loss": 0.41116613149642944,
|
| 128 |
+
"eval_precision": 0.9416901233513075,
|
| 129 |
+
"eval_recall": 0.9407894736842105,
|
| 130 |
+
"eval_runtime": 64.0989,
|
| 131 |
+
"eval_samples_per_second": 2.371,
|
| 132 |
+
"eval_steps_per_second": 0.296,
|
| 133 |
+
"eval_top1_accuracy": 0.9407894736842105,
|
| 134 |
"step": 190
|
| 135 |
},
|
| 136 |
{
|
| 137 |
"epoch": 6.0,
|
| 138 |
+
"train_accuracy": 0.9568713450292398
|
| 139 |
},
|
| 140 |
{
|
| 141 |
"epoch": 6.0,
|
| 142 |
+
"grad_norm": 2.5020029544830322,
|
| 143 |
+
"learning_rate": 5.219988165325166e-06,
|
| 144 |
+
"loss": 0.328,
|
| 145 |
"step": 228
|
| 146 |
},
|
| 147 |
{
|
| 148 |
"epoch": 6.0,
|
| 149 |
+
"eval_accuracy": 0.981111111111111,
|
| 150 |
+
"eval_error_rate": 0.018888888888888955,
|
| 151 |
+
"eval_f1": 0.980233547031901,
|
| 152 |
+
"eval_loss": 0.22286705672740936,
|
| 153 |
+
"eval_precision": 0.9808624413887572,
|
| 154 |
+
"eval_recall": 0.9802631578947368,
|
| 155 |
+
"eval_runtime": 65.9742,
|
| 156 |
+
"eval_samples_per_second": 2.304,
|
| 157 |
+
"eval_steps_per_second": 0.288,
|
| 158 |
+
"eval_top1_accuracy": 0.9802631578947368,
|
| 159 |
"step": 228
|
| 160 |
},
|
| 161 |
{
|
| 162 |
"epoch": 7.0,
|
| 163 |
+
"train_accuracy": 0.9707602339181286
|
| 164 |
},
|
| 165 |
{
|
| 166 |
"epoch": 7.0,
|
| 167 |
+
"grad_norm": 3.700869560241699,
|
| 168 |
+
"learning_rate": 6.346504377274108e-06,
|
| 169 |
+
"loss": 0.1837,
|
| 170 |
"step": 266
|
| 171 |
},
|
| 172 |
{
|
| 173 |
"epoch": 7.0,
|
| 174 |
+
"eval_accuracy": 0.9877777777777779,
|
| 175 |
+
"eval_error_rate": 0.012222222222222134,
|
| 176 |
+
"eval_f1": 0.9868484170131115,
|
| 177 |
+
"eval_loss": 0.11809363961219788,
|
| 178 |
+
"eval_precision": 0.9870857699805068,
|
| 179 |
"eval_recall": 0.9868421052631579,
|
| 180 |
+
"eval_runtime": 64.4539,
|
| 181 |
+
"eval_samples_per_second": 2.358,
|
| 182 |
+
"eval_steps_per_second": 0.295,
|
| 183 |
"eval_top1_accuracy": 0.9868421052631579,
|
| 184 |
"step": 266
|
| 185 |
},
|
| 186 |
{
|
| 187 |
"epoch": 8.0,
|
| 188 |
+
"train_accuracy": 0.9766081871345029
|
| 189 |
},
|
| 190 |
{
|
| 191 |
"epoch": 8.0,
|
| 192 |
+
"grad_norm": 1.4798824787139893,
|
| 193 |
+
"learning_rate": 7.622814335733349e-06,
|
| 194 |
+
"loss": 0.1131,
|
| 195 |
"step": 304
|
| 196 |
},
|
| 197 |
{
|
| 198 |
"epoch": 8.0,
|
| 199 |
+
"eval_accuracy": 0.9944444444444445,
|
| 200 |
+
"eval_error_rate": 0.005555555555555536,
|
| 201 |
+
"eval_f1": 0.99343678755752,
|
| 202 |
+
"eval_loss": 0.06803914159536362,
|
| 203 |
+
"eval_precision": 0.9936647173489279,
|
| 204 |
+
"eval_recall": 0.993421052631579,
|
| 205 |
+
"eval_runtime": 66.8397,
|
| 206 |
+
"eval_samples_per_second": 2.274,
|
| 207 |
+
"eval_steps_per_second": 0.284,
|
| 208 |
+
"eval_top1_accuracy": 0.993421052631579,
|
| 209 |
"step": 304
|
| 210 |
},
|
| 211 |
{
|
| 212 |
"epoch": 9.0,
|
| 213 |
+
"train_accuracy": 0.9912280701754386
|
| 214 |
},
|
| 215 |
{
|
| 216 |
"epoch": 9.0,
|
| 217 |
+
"grad_norm": 0.24450232088565826,
|
| 218 |
+
"learning_rate": 9.039190343704055e-06,
|
| 219 |
+
"loss": 0.0526,
|
| 220 |
"step": 342
|
| 221 |
},
|
| 222 |
{
|
| 223 |
"epoch": 9.0,
|
| 224 |
+
"eval_accuracy": 0.9944444444444445,
|
| 225 |
+
"eval_error_rate": 0.005555555555555536,
|
| 226 |
+
"eval_f1": 0.99343678755752,
|
| 227 |
+
"eval_loss": 0.0387217253446579,
|
| 228 |
+
"eval_precision": 0.9936647173489279,
|
| 229 |
+
"eval_recall": 0.993421052631579,
|
| 230 |
+
"eval_runtime": 62.2983,
|
| 231 |
+
"eval_samples_per_second": 2.44,
|
| 232 |
+
"eval_steps_per_second": 0.305,
|
| 233 |
+
"eval_top1_accuracy": 0.993421052631579,
|
| 234 |
"step": 342
|
| 235 |
},
|
| 236 |
{
|
| 237 |
"epoch": 10.0,
|
| 238 |
+
"train_accuracy": 0.9948830409356725
|
| 239 |
},
|
| 240 |
{
|
| 241 |
"epoch": 10.0,
|
| 242 |
+
"grad_norm": 0.18834975361824036,
|
| 243 |
+
"learning_rate": 1.0584837157796744e-05,
|
| 244 |
+
"loss": 0.0283,
|
| 245 |
"step": 380
|
| 246 |
},
|
| 247 |
{
|
| 248 |
"epoch": 10.0,
|
| 249 |
+
"eval_accuracy": 0.9877777777777779,
|
| 250 |
+
"eval_error_rate": 0.012222222222222134,
|
| 251 |
+
"eval_f1": 0.9868641519390525,
|
| 252 |
+
"eval_loss": 0.032834384590387344,
|
| 253 |
+
"eval_precision": 0.9873294346978557,
|
| 254 |
+
"eval_recall": 0.9868421052631579,
|
| 255 |
+
"eval_runtime": 65.4882,
|
| 256 |
+
"eval_samples_per_second": 2.321,
|
| 257 |
+
"eval_steps_per_second": 0.29,
|
| 258 |
+
"eval_top1_accuracy": 0.9868421052631579,
|
| 259 |
"step": 380
|
| 260 |
},
|
| 261 |
{
|
| 262 |
"epoch": 11.0,
|
| 263 |
+
"train_accuracy": 0.9956140350877193
|
| 264 |
},
|
| 265 |
{
|
| 266 |
"epoch": 11.0,
|
| 267 |
+
"grad_norm": 0.2787030041217804,
|
| 268 |
+
"learning_rate": 1.2247974266721769e-05,
|
| 269 |
+
"loss": 0.019,
|
| 270 |
"step": 418
|
| 271 |
},
|
| 272 |
{
|
| 273 |
"epoch": 11.0,
|
| 274 |
+
"eval_accuracy": 0.9888888888888889,
|
| 275 |
+
"eval_error_rate": 0.011111111111111072,
|
| 276 |
+
"eval_f1": 0.9867701266776593,
|
| 277 |
+
"eval_loss": 0.0223978441208601,
|
| 278 |
+
"eval_precision": 0.9872979940891655,
|
| 279 |
+
"eval_recall": 0.9868421052631579,
|
| 280 |
+
"eval_runtime": 66.7371,
|
| 281 |
+
"eval_samples_per_second": 2.278,
|
| 282 |
+
"eval_steps_per_second": 0.285,
|
| 283 |
+
"eval_top1_accuracy": 0.9868421052631579,
|
| 284 |
"step": 418
|
| 285 |
},
|
| 286 |
{
|
| 287 |
"epoch": 12.0,
|
| 288 |
+
"train_accuracy": 0.9963450292397661
|
| 289 |
},
|
| 290 |
{
|
| 291 |
"epoch": 12.0,
|
| 292 |
+
"grad_norm": 1.9764137268066406,
|
| 293 |
+
"learning_rate": 1.401592567923113e-05,
|
| 294 |
+
"loss": 0.0148,
|
| 295 |
"step": 456
|
| 296 |
},
|
| 297 |
{
|
| 298 |
"epoch": 12.0,
|
| 299 |
+
"eval_accuracy": 0.9888888888888889,
|
| 300 |
+
"eval_error_rate": 0.011111111111111072,
|
| 301 |
+
"eval_f1": 0.9867701266776593,
|
| 302 |
+
"eval_loss": 0.02013457380235195,
|
| 303 |
+
"eval_precision": 0.9872979940891655,
|
| 304 |
+
"eval_recall": 0.9868421052631579,
|
| 305 |
+
"eval_runtime": 62.9372,
|
| 306 |
+
"eval_samples_per_second": 2.415,
|
| 307 |
+
"eval_steps_per_second": 0.302,
|
| 308 |
+
"eval_top1_accuracy": 0.9868421052631579,
|
| 309 |
"step": 456
|
| 310 |
},
|
| 311 |
{
|
| 312 |
"epoch": 13.0,
|
| 313 |
+
"train_accuracy": 0.9963450292397661
|
| 314 |
},
|
| 315 |
{
|
| 316 |
"epoch": 13.0,
|
| 317 |
+
"grad_norm": 0.050672873854637146,
|
| 318 |
+
"learning_rate": 1.5875216537171772e-05,
|
| 319 |
+
"loss": 0.0095,
|
| 320 |
"step": 494
|
| 321 |
},
|
| 322 |
{
|
| 323 |
"epoch": 13.0,
|
| 324 |
+
"eval_accuracy": 0.9877777777777779,
|
| 325 |
+
"eval_error_rate": 0.012222222222222134,
|
| 326 |
+
"eval_f1": 0.9868484170131115,
|
| 327 |
+
"eval_loss": 0.03958281874656677,
|
| 328 |
+
"eval_precision": 0.9870857699805068,
|
| 329 |
+
"eval_recall": 0.9868421052631579,
|
| 330 |
+
"eval_runtime": 63.5973,
|
| 331 |
+
"eval_samples_per_second": 2.39,
|
| 332 |
+
"eval_steps_per_second": 0.299,
|
| 333 |
+
"eval_top1_accuracy": 0.9868421052631579,
|
| 334 |
"step": 494
|
| 335 |
},
|
| 336 |
{
|
| 337 |
"epoch": 14.0,
|
| 338 |
+
"train_accuracy": 0.9978070175438597
|
| 339 |
},
|
| 340 |
{
|
| 341 |
"epoch": 14.0,
|
| 342 |
+
"grad_norm": 0.06194866821169853,
|
| 343 |
+
"learning_rate": 1.7811675817291163e-05,
|
| 344 |
+
"loss": 0.007,
|
| 345 |
"step": 532
|
| 346 |
},
|
| 347 |
{
|
| 348 |
"epoch": 14.0,
|
| 349 |
+
"eval_accuracy": 1.0,
|
| 350 |
+
"eval_error_rate": 0.0,
|
| 351 |
+
"eval_f1": 1.0,
|
| 352 |
+
"eval_loss": 0.0047844694927334785,
|
| 353 |
+
"eval_precision": 1.0,
|
| 354 |
+
"eval_recall": 1.0,
|
| 355 |
+
"eval_runtime": 63.8972,
|
| 356 |
+
"eval_samples_per_second": 2.379,
|
| 357 |
+
"eval_steps_per_second": 0.297,
|
| 358 |
+
"eval_top1_accuracy": 1.0,
|
| 359 |
+
"step": 532
|
| 360 |
+
},
|
| 361 |
+
{
|
| 362 |
+
"epoch": 15.0,
|
| 363 |
+
"train_accuracy": 0.9956140350877193
|
| 364 |
+
},
|
| 365 |
+
{
|
| 366 |
+
"epoch": 15.0,
|
| 367 |
+
"grad_norm": 0.3071841597557068,
|
| 368 |
+
"learning_rate": 1.9810544339029155e-05,
|
| 369 |
+
"loss": 0.011,
|
| 370 |
+
"step": 570
|
| 371 |
+
},
|
| 372 |
+
{
|
| 373 |
+
"epoch": 15.0,
|
| 374 |
+
"eval_accuracy": 1.0,
|
| 375 |
+
"eval_error_rate": 0.0,
|
| 376 |
+
"eval_f1": 1.0,
|
| 377 |
+
"eval_loss": 0.003647729055956006,
|
| 378 |
+
"eval_precision": 1.0,
|
| 379 |
+
"eval_recall": 1.0,
|
| 380 |
+
"eval_runtime": 65.5965,
|
| 381 |
+
"eval_samples_per_second": 2.317,
|
| 382 |
+
"eval_steps_per_second": 0.29,
|
| 383 |
+
"eval_top1_accuracy": 1.0,
|
| 384 |
+
"step": 570
|
| 385 |
+
},
|
| 386 |
+
{
|
| 387 |
+
"epoch": 16.0,
|
| 388 |
+
"train_accuracy": 0.9978070175438597
|
| 389 |
+
},
|
| 390 |
+
{
|
| 391 |
+
"epoch": 16.0,
|
| 392 |
+
"grad_norm": 0.05617503821849823,
|
| 393 |
+
"learning_rate": 2.1856587255089357e-05,
|
| 394 |
+
"loss": 0.0071,
|
| 395 |
+
"step": 608
|
| 396 |
+
},
|
| 397 |
+
{
|
| 398 |
+
"epoch": 16.0,
|
| 399 |
+
"eval_accuracy": 0.9941176470588236,
|
| 400 |
+
"eval_error_rate": 0.00588235294117645,
|
| 401 |
+
"eval_f1": 0.9934170172927719,
|
| 402 |
+
"eval_loss": 0.009170782752335072,
|
| 403 |
+
"eval_precision": 0.9935988620199147,
|
| 404 |
"eval_recall": 0.993421052631579,
|
| 405 |
+
"eval_runtime": 66.4048,
|
| 406 |
+
"eval_samples_per_second": 2.289,
|
| 407 |
+
"eval_steps_per_second": 0.286,
|
| 408 |
"eval_top1_accuracy": 0.993421052631579,
|
| 409 |
+
"step": 608
|
| 410 |
},
|
| 411 |
{
|
| 412 |
+
"epoch": 17.0,
|
| 413 |
+
"train_accuracy": 0.9963450292397661
|
| 414 |
+
},
|
| 415 |
+
{
|
| 416 |
+
"epoch": 17.0,
|
| 417 |
+
"grad_norm": 0.02715430036187172,
|
| 418 |
+
"learning_rate": 2.393421016741653e-05,
|
| 419 |
+
"loss": 0.0103,
|
| 420 |
+
"step": 646
|
| 421 |
+
},
|
| 422 |
+
{
|
| 423 |
+
"epoch": 17.0,
|
| 424 |
+
"eval_accuracy": 0.9944444444444445,
|
| 425 |
+
"eval_error_rate": 0.005555555555555536,
|
| 426 |
+
"eval_f1": 0.9934286478144102,
|
| 427 |
+
"eval_loss": 0.014811488799750805,
|
| 428 |
+
"eval_precision": 0.9936332767402377,
|
| 429 |
+
"eval_recall": 0.993421052631579,
|
| 430 |
+
"eval_runtime": 64.9042,
|
| 431 |
+
"eval_samples_per_second": 2.342,
|
| 432 |
+
"eval_steps_per_second": 0.293,
|
| 433 |
+
"eval_top1_accuracy": 0.993421052631579,
|
| 434 |
+
"step": 646
|
| 435 |
+
},
|
| 436 |
+
{
|
| 437 |
+
"epoch": 17.0,
|
| 438 |
+
"step": 646,
|
| 439 |
+
"total_flos": 1.601957481669329e+18,
|
| 440 |
+
"train_loss": 0.3558414801263219,
|
| 441 |
+
"train_runtime": 14288.2591,
|
| 442 |
+
"train_samples_per_second": 2.553,
|
| 443 |
+
"train_steps_per_second": 0.08
|
| 444 |
}
|
| 445 |
],
|
| 446 |
+
"logging_steps": 10,
|
| 447 |
"max_steps": 1140,
|
| 448 |
"num_input_tokens_seen": 0,
|
| 449 |
"num_train_epochs": 30,
|
|
|
|
| 451 |
"stateful_callbacks": {
|
| 452 |
"EarlyStoppingCallback": {
|
| 453 |
"args": {
|
| 454 |
+
"early_stopping_patience": 2,
|
| 455 |
"early_stopping_threshold": 0.0
|
| 456 |
},
|
| 457 |
"attributes": {
|
| 458 |
+
"early_stopping_patience_counter": 0
|
| 459 |
}
|
| 460 |
},
|
| 461 |
"TrainerControl": {
|
|
|
|
| 469 |
"attributes": {}
|
| 470 |
}
|
| 471 |
},
|
| 472 |
+
"total_flos": 1.601957481669329e+18,
|
| 473 |
+
"train_batch_size": 8,
|
| 474 |
"trial_name": null,
|
| 475 |
"trial_params": null
|
| 476 |
}
|
training_args.bin
CHANGED
|
@@ -1,3 +1,3 @@
|
|
| 1 |
version https://git-lfs.github.com/spec/v1
|
| 2 |
-
oid sha256:
|
| 3 |
size 5176
|
|
|
|
| 1 |
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:cf88fd2cbab55edfe4073469846fa48192ab595fedef138b7aa73e05d0927aad
|
| 3 |
size 5176
|